Corentin Cadiou\({}^1\) (cadiou@iap.fr)
Lead developers: Maxime Delorme (CEA), Arnaud Durocher (CEA)
Scientific collaborators:
Dominique Aubert (ObAS), Olivier Marchal (ObAS), San Han (IAP), Guillaume Tcherniatinsky (IAP), Harley Katz (U. Chicago), …
\({}^1\)Institut d’Astrophysique de Paris, CNRS, France

Dyablo:
A New General-Purpose
GPU-Accelerated
Hydrodynamical Code for Astrophysics


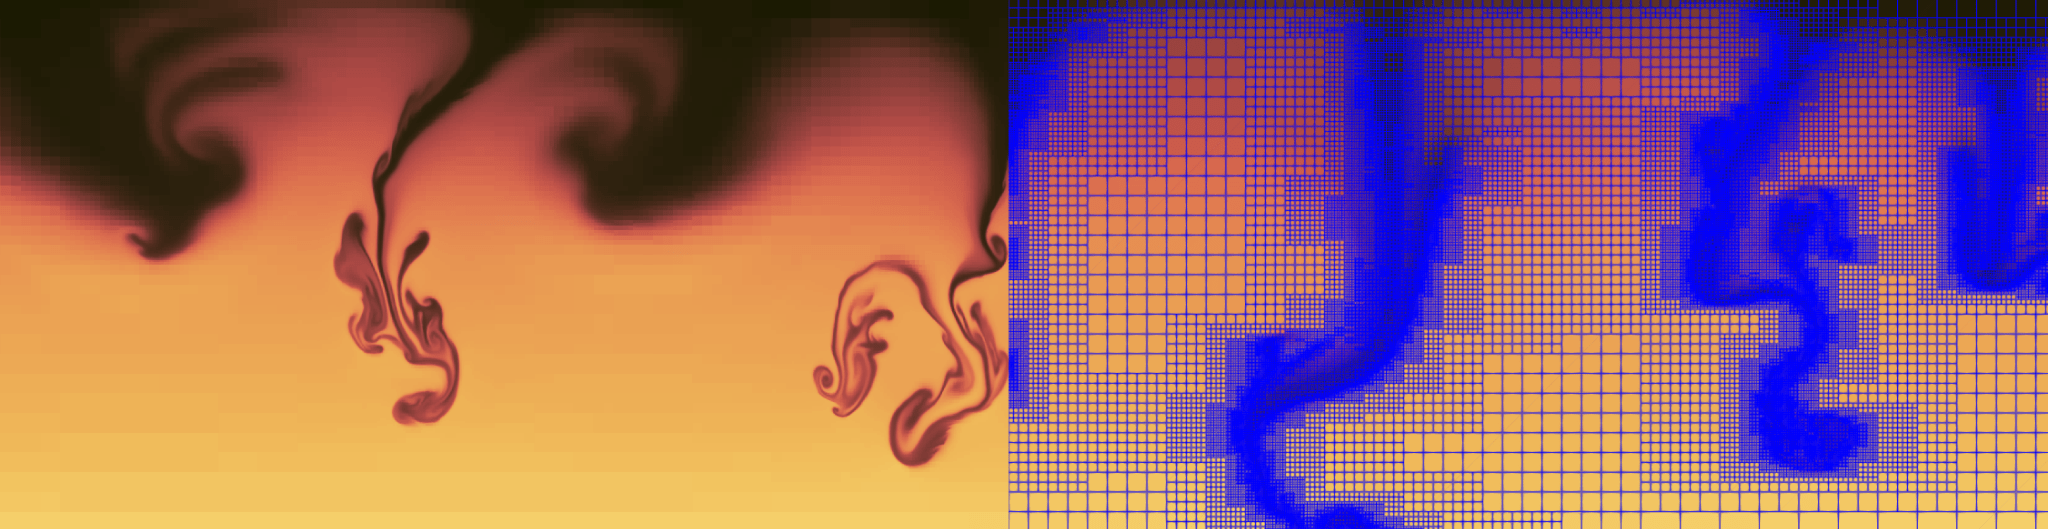
Credits: M. Delorme
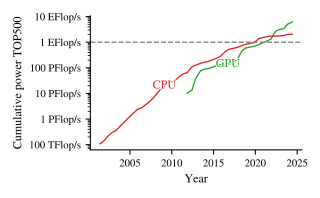
Data: Top-500
Manage grid, simple computation
Computation-heavy
(hydro, gravity, …)
CPU
GPU
[…]
wasted
time
wasted
time
Typical approach: offloading
Dyablo's approach:
Amdahl's law: latency kills gains of parallelisation
Manage grid, simple computation
Computation-heavy
(hydro, gravity, …)
CPU
GPU
(or CPUs)
[…]
Typical approach: offloading
Dyablo's approach: “true” GPU computing, CPU as a puppeteer
Manage grid, simple computation
Computation-heavy
(hydro, gravity, …)
[…]
Typical approach: offloading
Dyablo's approach: “true” GPU computing, CPU as a puppeteer
1. Separation of concerns
Physicists: write subgrid models
Computer scientists:
optimize the code
2. Abstraction
Physics: independent of data layout, parallelization, ...
Code should provide high-level APIs
3. Modularity
Implementations & models should be interchangeable depending on needs
CPU
GPU
(or CPUs)
Dyablo: Overall design
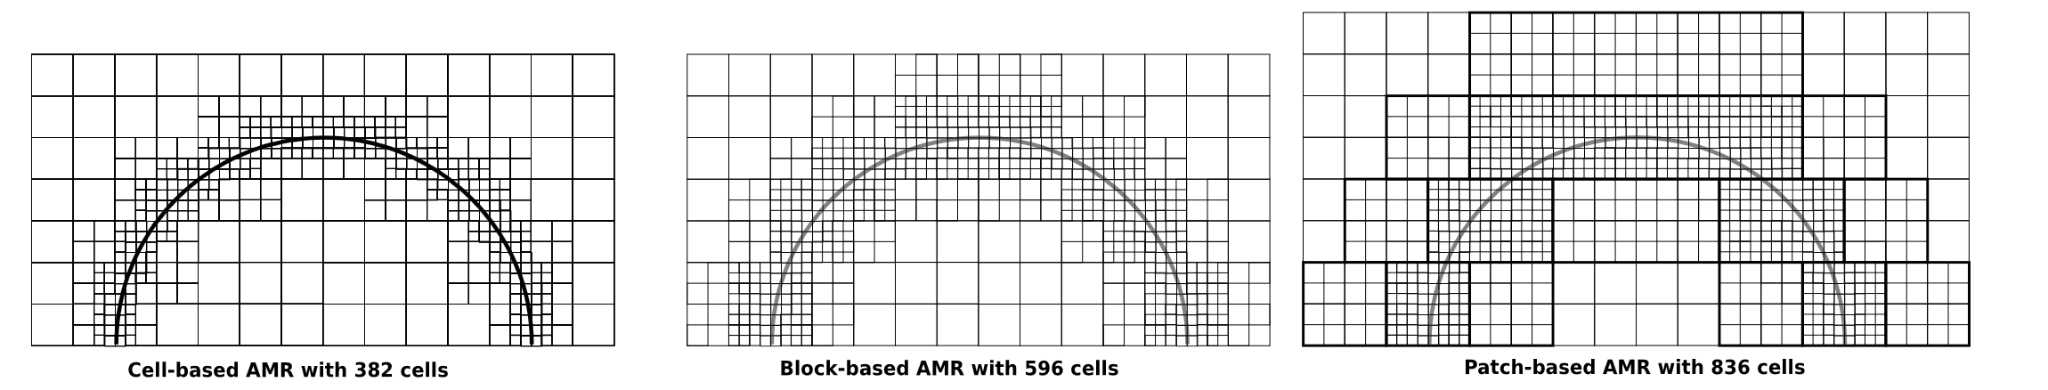
Cell or block-based
Adaptive Mesh Refinement
Collection of \(N\times M\times L\) blocks
Traditional oct-based AMR
Dyablo: Overall design
[...]

// Memory abstracted
Kokkos::View<double**> U(Ncell, Nfields);

// Parallelism abstracted
Kokkos::parallel_for(Ncell, KOKKOS_LAMBDA(size_t iCell) {
   U(iCell, IRho) += ...
});

[...]
or
or
Single node / GPU
Dyablo: Overall design
[...]

// Memory abstracted
Kokkos::View<double**> U(Ncell, Nfields);

// Parallelism abstracted
Kokkos::parallel_for(Ncell, KOKKOS_LAMBDA(size_t iCell) {
   U(iCell, IRho) += ...
});

[...]
[...]
// Memory abstracted
Kokkos::View<double**> U(Ncell, Nfields);
// Parallelism abstracted
Kokkos::parallel_for(Ncell, KOKKOS_LAMBDA(size_t iCell) {
U(iCell, IRho) += ...
});
[...][...]
// Memory abstracted
Kokkos::View<double**> U(Ncell, Nfields);
// Parallelism abstracted
Kokkos::parallel_for(Ncell, KOKKOS_LAMBDA(size_t iCell) {
U(iCell, IRho) += ...
});
[...][...]
// Memory abstracted
Kokkos::View<double**> U(Ncell, Nfields);
// Parallelism abstracted
Kokkos::parallel_for(Ncell, KOKKOS_LAMBDA(size_t iCell) {
U(iCell, IRho) += ...
});
[...][...]
// Memory abstracted
Kokkos::View<double**> U(Ncell, Nfields);
// Parallelism abstracted
Kokkos::parallel_for(Ncell, KOKKOS_LAMBDA(size_t iCell) {
U(iCell, IRho) += ...
});
[...]
Dyablo: Implemented physics
- Block-based adaptive mesh-refinement,
- Hydrodynamics / MHD / radiative transfer
- (Self-)Gravity
- Particles,
- Diffusion terms: thermal conduction, viscosity,
- Cosmology: Comoving coordinates,
— Ongoing — - Star formation and feedback,
- (Non-equilibrium) thermochemistry,
- Cosmic rays, ...
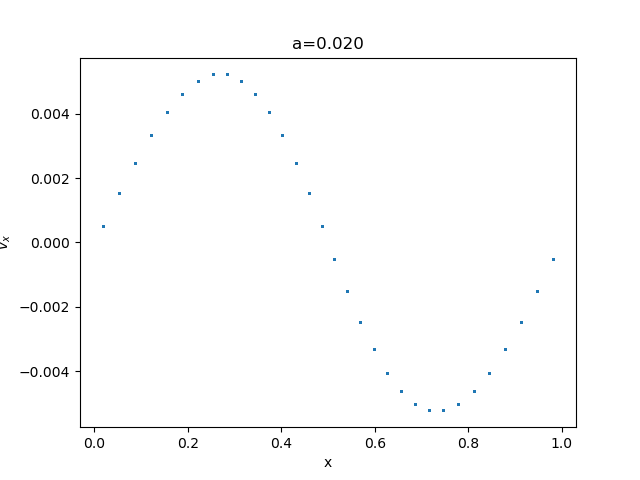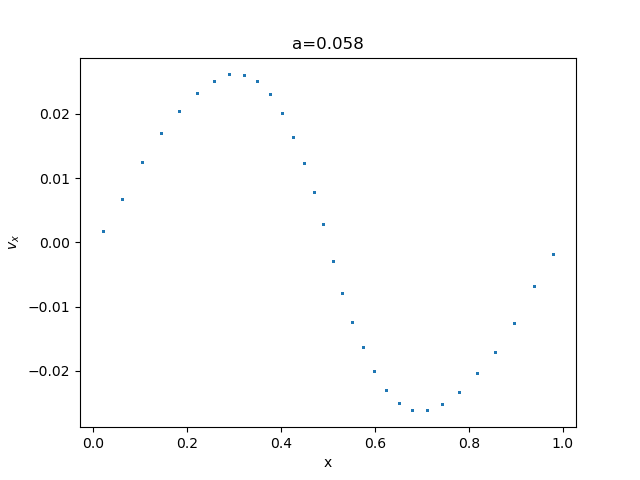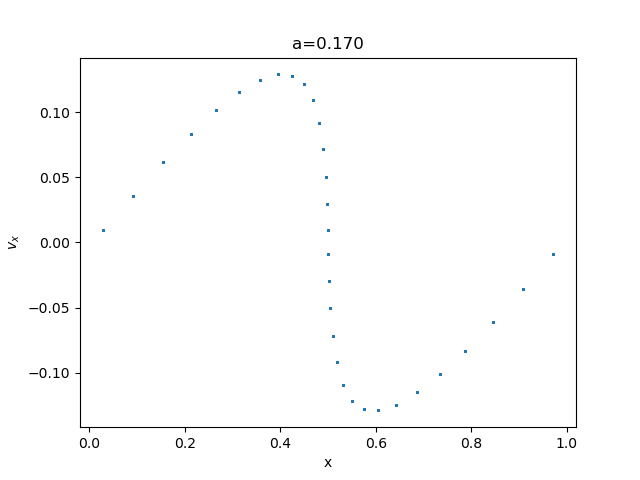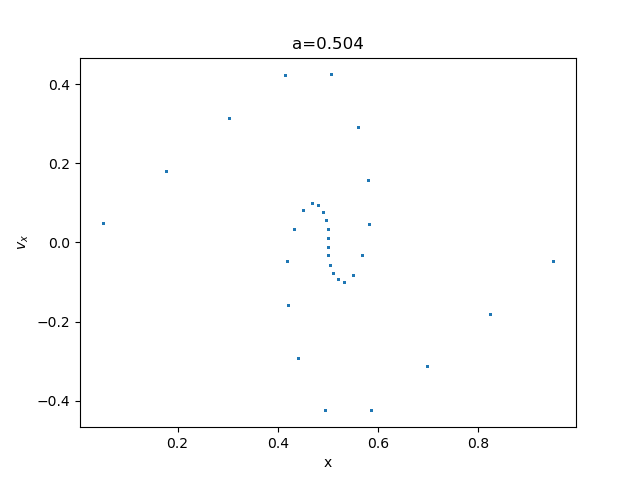
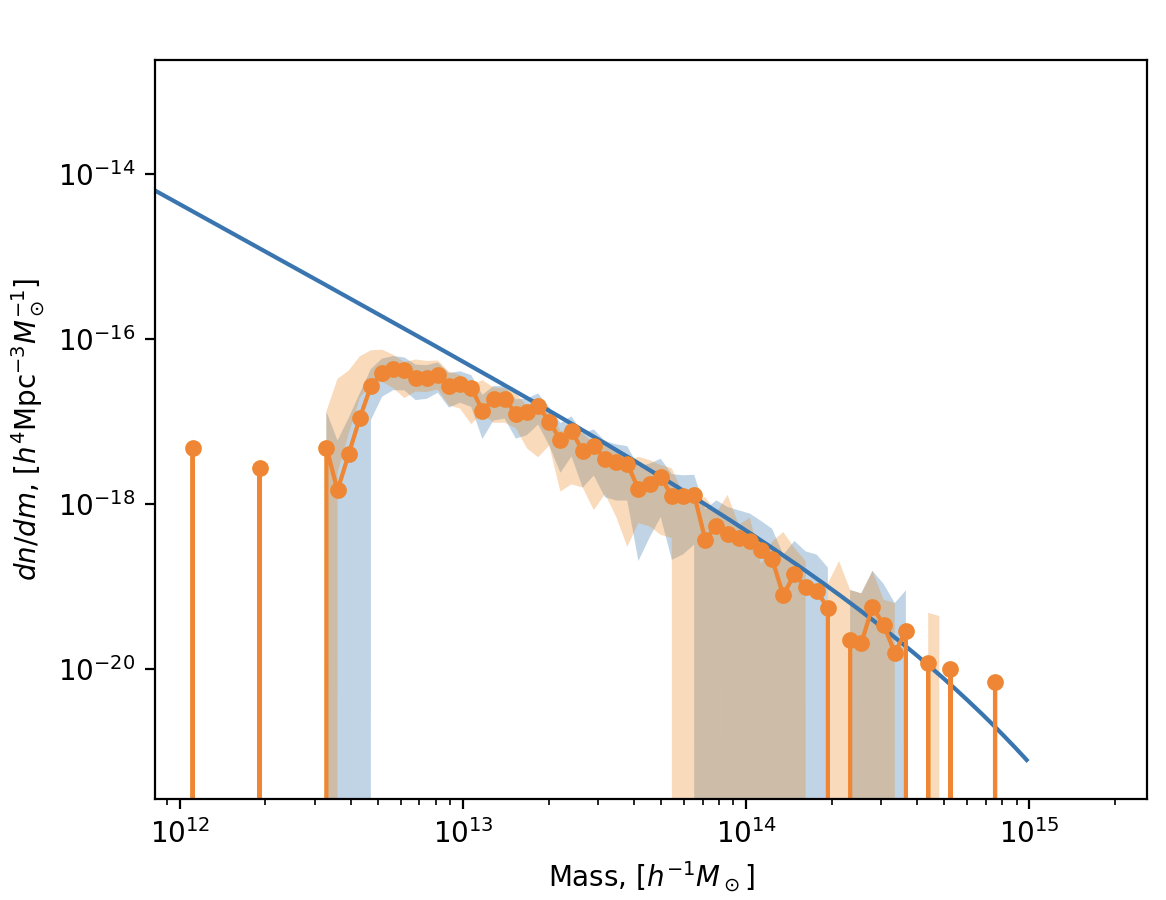
Solar convection (Delorme)
Zeldovich pancake (Aubert & Marchal)
Halo mass function (Aubert & Marchal)
Thermochem. (Cadiou & Katz)
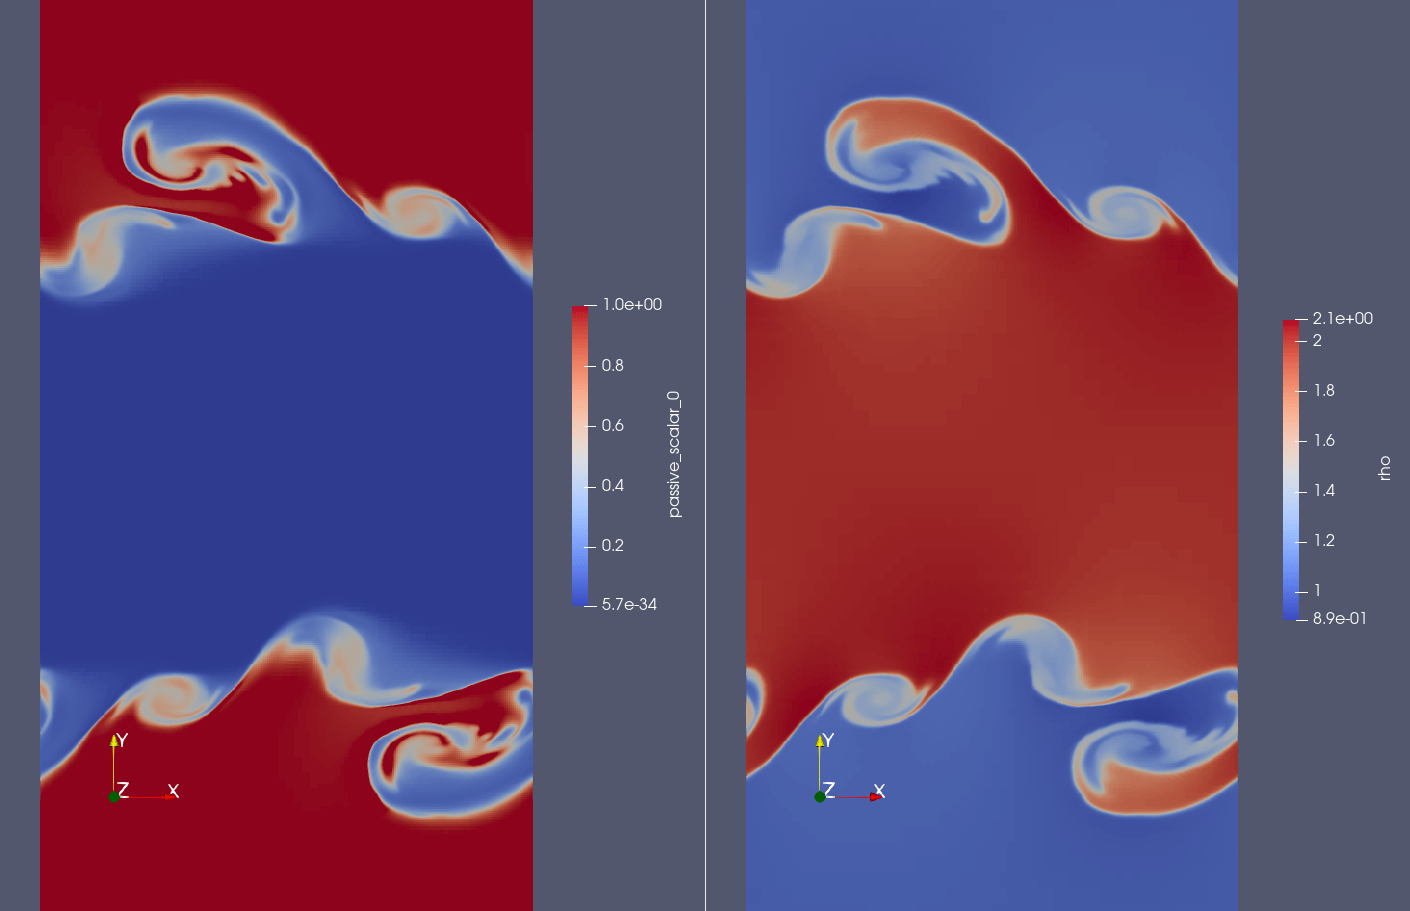
KH instability (Delorme)
Dyablo: how does it scale?
— weak scaling: solar convection
Image credits: Maxime Delorme
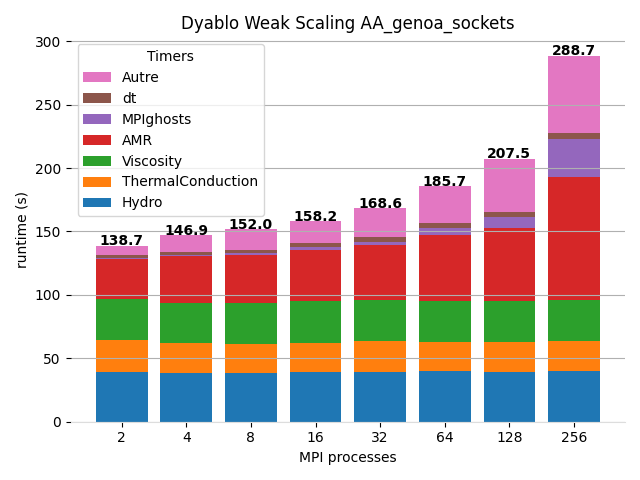
Ad Astra CPU (2 x AMD Epyc Genoa 96 cores )
24,576 cores
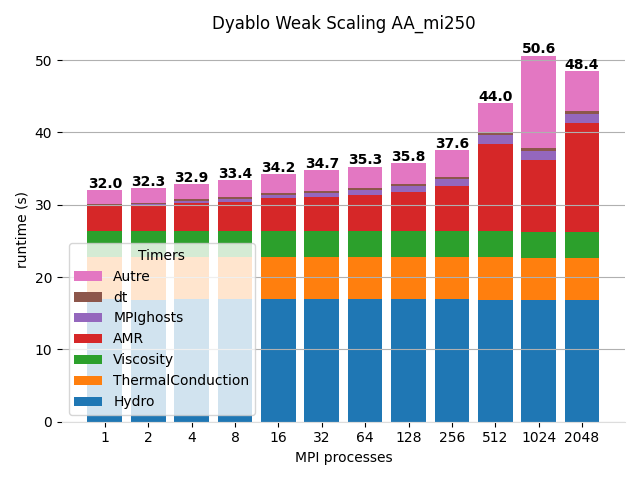
Ad Astra GPU (4 AMD MI250 x2 GCD )
Note: some updates in the code between left & right, raw perfs cannot be compared directly
Hydro only: \(\sim 200\,\mathrm{Mcell/s}\)
AthenaK \(\sim1000\,\mathrm{Mcell/s}\), Stone+24
Cholla-MHD \(\sim 200\, \mathrm{Mcell/s}\), Caddy+24,
AREPO-RT \(\sim 1\,\mathrm{Mcell/s}\), Zier+24
Shamrock \(\sim 10\,\mathrm{Mcell/s}\), David-Cléris+25
13,631,488 “cores”
Dyablo:
A New General-Purpose
GPU-Accelerated
Hydrodynamical Code for Astrophysics
Physics: hydrodynamics, MHD, RT, gravity, cosmology, ...
Efficient scaling up to 10,000+ CPUs, 1000+ GPUs
Modular and future-proof code
Credits: M. Delorme
Dyablo-HPC/Dyablo
Corentin Cadiou (cadiou@iap.fr)